截图工具不管文字
截完就是一张图,想复制里面的字还得再 OCR 一遍。
截图 → OCR → 翻译 → 润色/总结,整条链路都能完全离线跑。识别与翻译都在本机完成,敏感内容不出机器;云端大模型是可选增强,默认关闭。
日常要干的活大概是:看到屏幕上某段内容,想把它变成能复制、能翻译、能总结的文字。而这件事通常要在三个工具之间来回倒腾。
截完就是一张图,想复制里面的字还得再 OCR 一遍。
识别出来了,但语言不通的部分还得自己另找地方翻。
把整段内容发到别人的服务器上 —— 合同、工单、病历、代码,都要先想想能不能发。
ScreenMind 把这一段串起来,而且能离线
截图就地批注、一键 OCR、本地模型翻译、需要时再交给云端润色总结。识别和翻译都在本机跑,网络是可选项而不是前提。
从按下热键到拿到可用的文字,中间没有需要你自己补的地方。
全屏 / 区域 / 窗口 / 定时;多屏与高 DPI 适配,缩放屏上也不会错位。
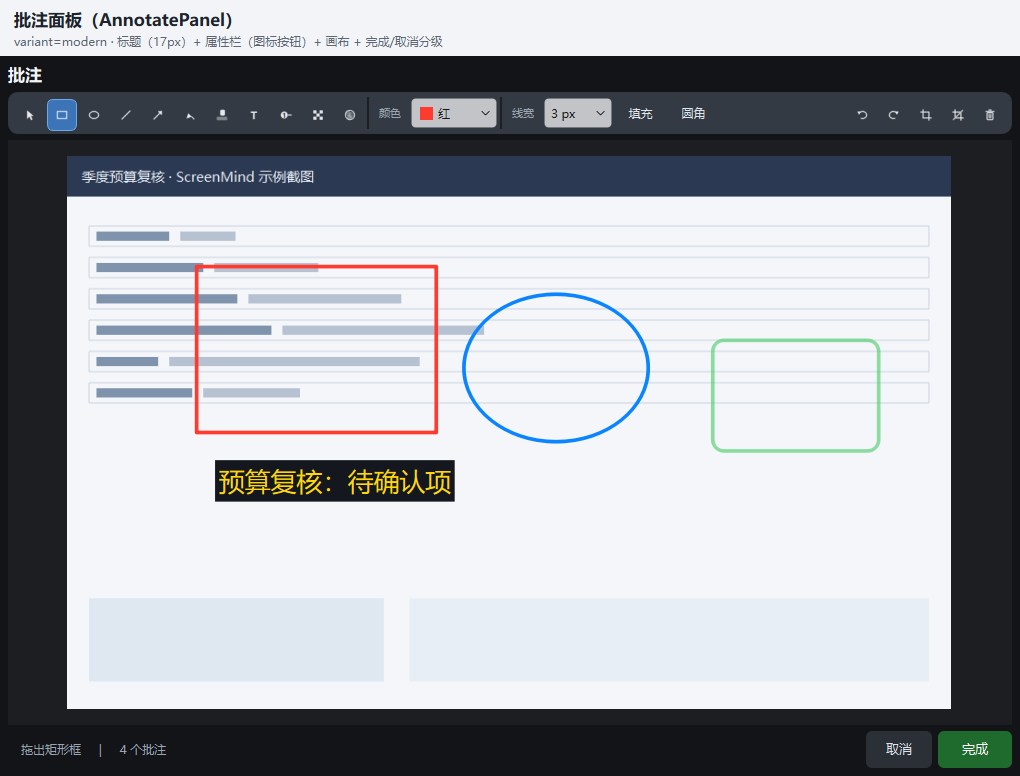
矩形、椭圆、箭头、画笔、文字、马赛克、裁剪;撤销/重做、拖动、缩放、旋转。截完图眼前就是那张图,画完直接走。
PP-OCRv6 + ONNX Runtime,中英混排;结果按段落聚合,可以按行查看、单段复制。
热键框一块区域,文字直接进剪贴板:不弹批注条、不开结果面板。看一眼就走的场景用这个。
日常短句用传统 NMT(NLLB-200 / CTranslate2),长文和需要语气的用本地大模型(混元 Hy-MT2)。两档都不联网。
自定义提示词 + 术语表,保证专有名词不被改写。翻译与润色可以挂两个不同的云端模型。
zxing-cpp 主引擎,52 种格式;识别后在码上画圈并点击跳转,也认 33px 这种极小码。
在任意程序里拖选文字,工具栏跟着鼠标弹出:翻译、解释、润色、复制。用完自动收起。
框选区域后自动滚动、逐帧截取、特征对齐拼接;自动滚动失败时退化为手动滚动拼接。
把 AI 处理页当作可继续追问的对话;也能把一段内容直接展开成可折叠的思维导图。
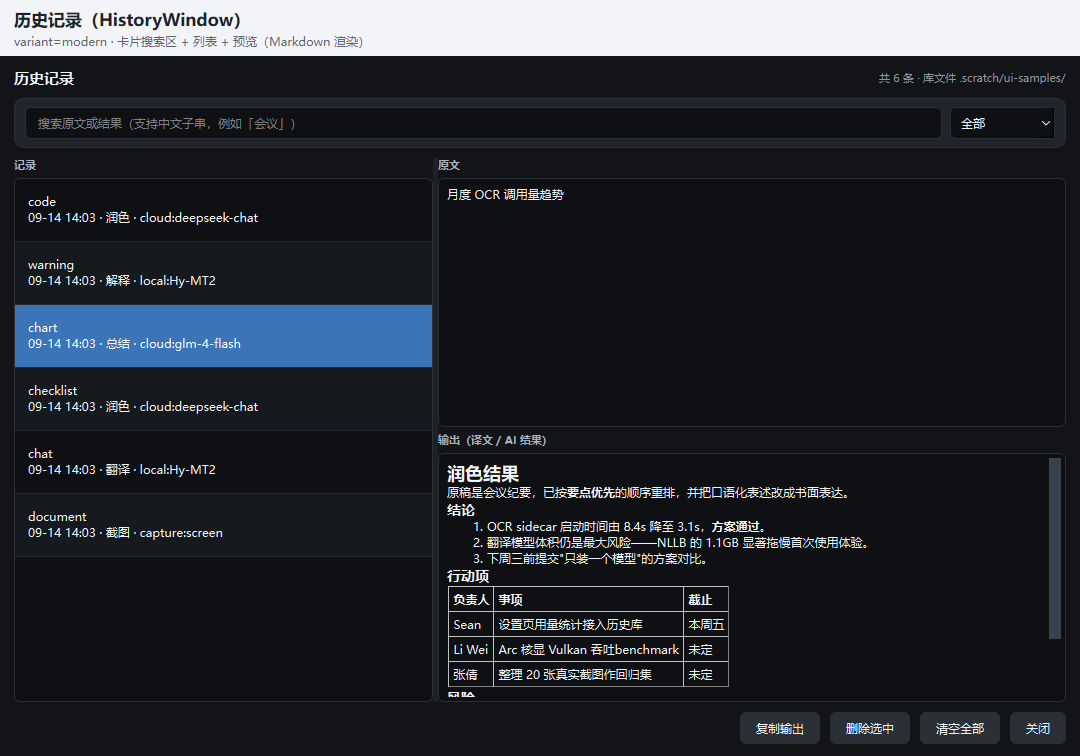
SQLite + FTS5,闲时自动 OCR 建索引;找几个月前截的那张图,靠关键词就够了。
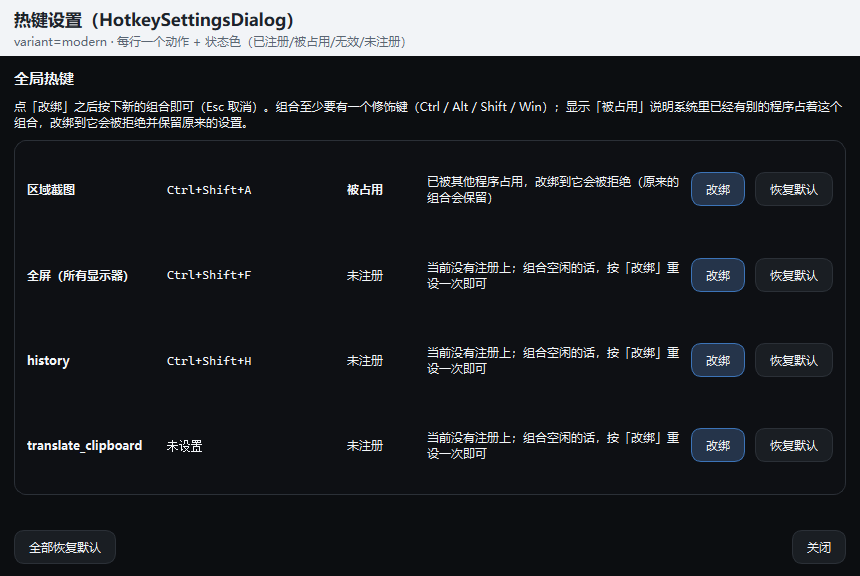
全局热键(可改绑、冲突会告诉你是谁占了)、常驻托盘、钉图、取色复制、在线更新。
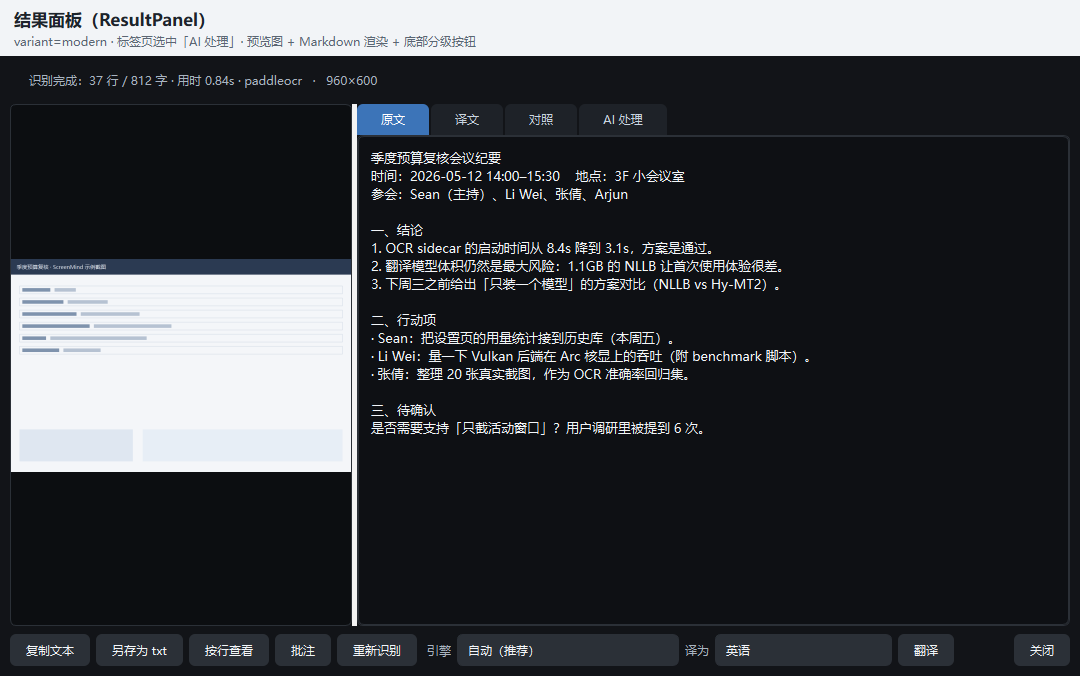
下面都是真实截图,不是效果图。配色默认跟随系统深浅色,切换不用重启。点开可以看大图。
OCR 引擎崩了不会拖垮主程序,主包也不用背那棵依赖树。端口由系统分配,绝不硬编码。
                    ┌──────────────────────────────────┐
                    │  ScreenMind.exe   (PySide6)      │
   热键 / 托盘 ────▶│  截图 · 批注 · 结果面板 · 历史   │
                    └───────┬───────────────┬──────────┘
                            │ HTTP 127.0.0.1│
              ┌─────────────▼──────┐  ┌─────▼──────────────────┐
              │ OCR worker         │  │ llama-server           │
              │ 与主程序同一个 exe │  │ llama.cpp (CPU)        │
              │ --ocr-worker       │  │ 混元 Hy-MT2            │
              │ ONNX Runtime       │  └────────────────────────┘
              └────────────────────┘
                    ┌──────────────────────────────────┐
                    │  ScreenMind.exe   (PySide6)      │
   hotkey / tray ──▶│  capture · annotate · results    │
                    └───────┬───────────────┬──────────┘
                            │ HTTP 127.0.0.1│
              ┌─────────────▼──────┐  ┌─────▼──────────────────┐
              │ OCR worker         │  │ llama-server           │
              │ the same executable│  │ llama.cpp (CPU)        │
              │ --ocr-worker       │  │ Hunyuan Hy-MT2         │
              │ ONNX Runtime       │  └────────────────────────┘
              └────────────────────┘
只带一份 CPython + numpy + onnxruntime + opencv;升级时也不会出现「主程序换了、worker 还是老的」。
截图 OCR 是最简单的场景(渲染文字、无透视、无噪点)。实测 tiny 档和 medium 档精度完全一样(行命中 8/8、字符准确率 0.996),但 tiny 快 9.6 倍、模型小 23 倍。
所有出网请求走同一套代理规则,显式传 proxy 而不是依赖环境变量 —— 本地回环请求绝不能走代理。
传统 NMT 快而省内存,本地大模型更懂语气。两档都在本机,按场景选,不用为了翻译把内容发出去。
在一台 8 逻辑核的机器上测的。同一批 4K 截图、同一批真实语料,换引擎前后对照。
线程数必须保守:这台 8 核机器上给 8 线程反而比 4 线程慢 15 倍 —— 超订把线程池拖垮了。
| 场景 | 旧方案(PaddleOCR) | 现在(ONNX Runtime) |
|---|---|---|
| 冷启动到能识别 | 8 ~ 18 s | 0.67 s |
| 引擎加载 | 5.3 s | 281 ms |
| 41 张真实截图语料 | 81.5 s | 13.2 s(6~7×) |
| 4K 截图 | 58.7 s | 约 1.1 s |
| 程序启动(到托盘可交互) | — | 0.74 s |
OCR worker 空闲常驻内存约 73 MB;处理过大图之后会涨到 350~450 MB(ONNX Runtime 的 arena 不还内存),空闲 10 分钟自动退出释放。
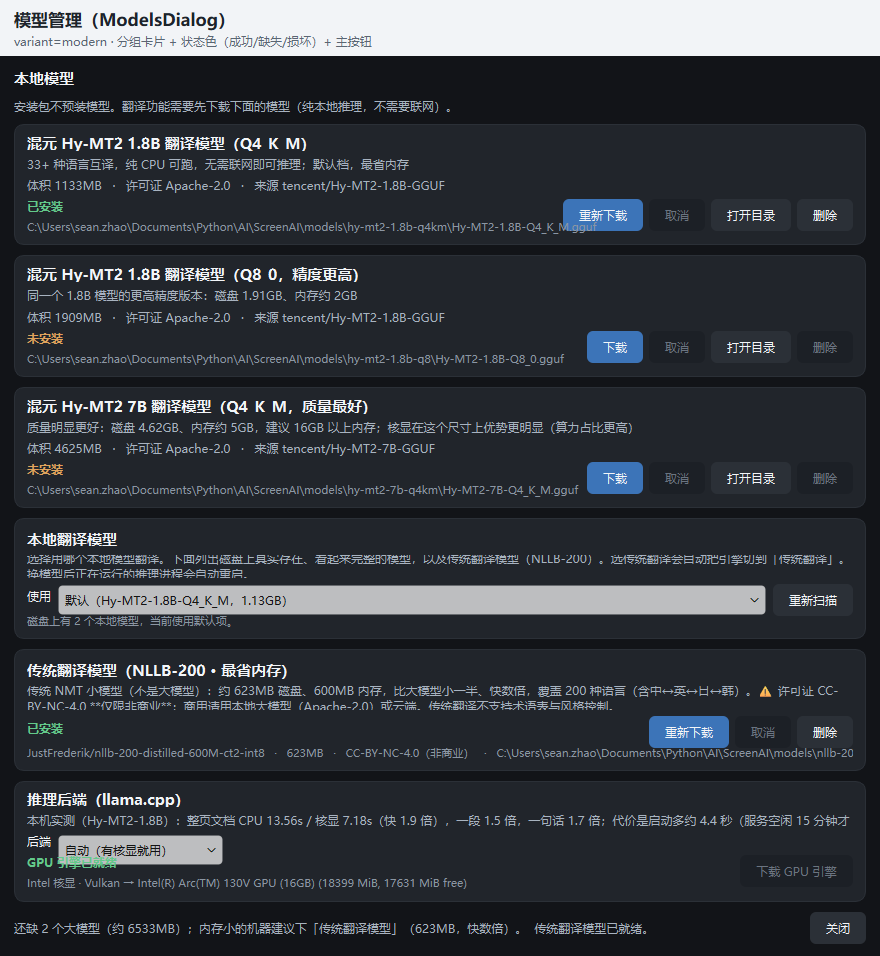
大模型是 1~2 GB 量级,让所有人下载一遍不合理。OCR 模型随包发,装完就能识别。
| 模型 | 体积 | 用途 | 许可证 |
|---|---|---|---|
| 混元 Hy-MT2 1.8B Q4_K_M | 1.08 GB | 本地翻译(推荐) | Apache-2.0 |
| 混元 Hy-MT2 1.8B Q8_0 | 1.82 GB | 本地翻译(更高质量) | Apache-2.0 |
| 混元 Hy-MT2 7B Q4_K_M | 4.41 GB | 本地翻译(长文 / 语气) | Apache-2.0 |
| NLLB-200 600M int8 | 617 MB | 传统翻译(快、省内存) | CC-BY-NC-4.0(非商业) |
| PP-OCRv6 tiny(随包) | 6 MB | OCR,装完即可用 | Apache-2.0 |
NLLB-200 是非商业许可。商用构建请用 --no-ct2 去掉传统翻译,只保留 Hy-MT2 与云端。
llama.cpp 推理引擎(CPU 版,45 MB)也已随包,不需要单独装。
这不是一句口号,是默认配置决定的:云端能力默认关闭,本地能力不需要网络。
截图、批注、OCR、历史检索,以及两档本地翻译,全部在本机进程内完成。
润色/总结/对话要走云端,必须你自己填 API Key 并打开开关;不打开就永远走本地。
主程序与 OCR worker、llama-server 之间是 127.0.0.1 上的本地 HTTP,明确排除在代理规则之外。
唯一会主动联网的事情是检查更新:只发程序名与版本号,用来判断要不要提示你,不包含任何截图或文字内容。
完整的数据流向与全部第三方许可
下载 setup.exe 直接装,装到用户目录,不需要管理员权限、不弹 UAC。可以直接覆盖旧版,模型与历史都保留。
这是因为目前没有代码签名证书,不是误报。点「更多信息 → 仍要运行」即可;有证书后这个问题自然消失。
默认区域截图是 Ctrl+Shift+S,静默 OCR 直接进剪贴板是 Ctrl+Shift+O;全屏 / 窗口 / 长截图分别是 Ctrl+Shift+A / W / L。都能在设置里改绑,冲突会明确告诉你是谁占了。
托盘图标可能在 Windows 11 的溢出区(任务栏右下角的 ^ 箭头里)—— 程序本身完全正常,拖出来固定住即可。
因为安装包没有代码签名证书,Windows 对任何未签名的可执行文件都会这么提示,不是误报,也不是被查出了什么。点「更多信息 → 仍要运行」即可。另外程序刻意做成 onedir 而不是 onefile、也没有开 UPX ——「自解压 + 释放可执行文件」正是杀软最爱的 dropper 特征,省下的体积不值得。
是。安装包里不含大模型(1~2 GB 量级),首次要用本地翻译时在程序里的「模型管理」按需下载。OCR 模型是随包发的,装完就能识别,不需要额外下载。
默认只做一件事:检查更新(只发程序名与版本号)。截图、OCR、本地翻译都不联网。云端润色/总结/对话需要你自己填 API Key 并打开开关,那时候发出去的是识别后的文字或你指定的图片 —— 用不用由你决定。
Windows 是逐项验证过的主平台。Linux / macOS 有回落实现(截图走 mss、窗口枚举走 pywinctl、热键走 pynput),但没有像 Windows 这样逐项验证过,属于「部分可用」。
需要看两点。一是仓库自身代码目前尚未选定开源许可证(未声明 = 默认保留所有权利),要商用请先确认授权。二是传统翻译用的 NLLB-200 是 CC-BY-NC-4.0 非商业许可,商用构建必须用 --no-ct2 去掉它,只保留 Hy-MT2(Apache-2.0)与云端。
0.7.0 起内置了在线更新:托盘菜单「检查更新」,或者在设置里打开自动检查。下载支持中断续传,边下边算哈希,校验不过就删掉重来。也可以直接下载新的 setup.exe 覆盖安装。
OCR 在 41 张真实语料上的平均相似度是 0.9452(26/41 达到 0.98 以上),仍有单字级差异,多数是 0 与 O、1 与 l 这类本身就有歧义的字符。二维码方面,带中心 logo(超过 10%)或四角被圆角切掉(超过宽/6)的码属于信息已被破坏,算法层面救不回来 —— 这种情况程序会明确说「未识别到」并给排查建议,而不是假装成功。
Windows 10 / 11(64 位)。免管理员权限、免登录,装完即可识别。
c25c8609567afbf057b80c6310dee391fc811cbcf6e48a67bb9bbfc7d853fe94
首次运行如遇 SmartScreen「未知发布者」,是未签名所致,选「更多信息 → 仍要运行」。